 绪言
宇宙好欧博娱乐城,我是捡田螺的小男孩。
日常建造中,咱们世俗会使用到group by。亲爱的小伙伴,你是否知谈group by的职责旨趣呢?group by和having有什么永别呢?group by的优化念念路是如何的呢?使用group by有哪些需要珍重的问题呢?本文将跟宇宙全部来学习,攻克group by~
使用group by的浮浅例子 group by 职责旨趣 group by + where 和 having的永别 group by 优化念念路 group by 使用珍重点 一个分娩慢SQL如何优化 1. 使用group by的浮浅例子group by一般用于分组统计,它抒发的逻辑即是证实一定的规则,进行分组。咱们先从一个浮浅的例子,全部来温习一下哈。
ag百家乐假定用一张职工表,表结构如下:
CREATE 欧博娱乐城TABLE `staff` ( `id` bigint(11) NOT NULL AUTO_INCREMENT COMMENT '主键id', `id_card` varchar(20) NOT NULL COMMENT '身份证号码', `name` varchar(64) NOT NULL COMMENT '姓名', `age` int(4) NOT NULL COMMENT '年事', `city` varchar(64) NOT NULL COMMENT '城市', PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=15 DEFAULT CHARSET=utf8 COMMENT='职工表';
表存量的数据如下:
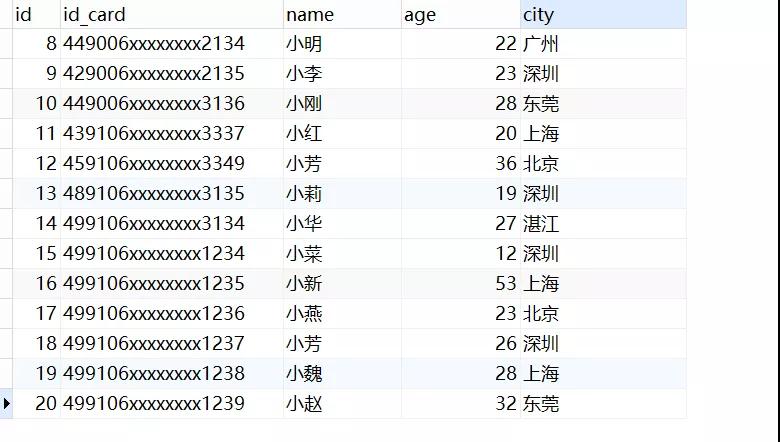
咱们当今有这样一个需求:统计每个城市的职工数目。对应的 SQL 语句就不错这样写:
select city ,count(*) as num from staff group by city;
奉行扫尾如下:
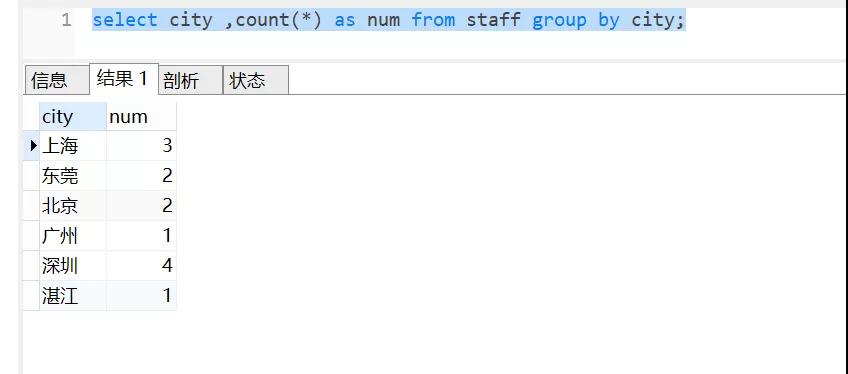
这条SQL语句的逻辑很明晰啦,关联词它的底层奉行进程是如何的呢?
2. group by 旨趣分析 2.1 explain 分析咱们先用explain检察一下奉行筹划
explain select city ,count(*) as num from staff group by city;
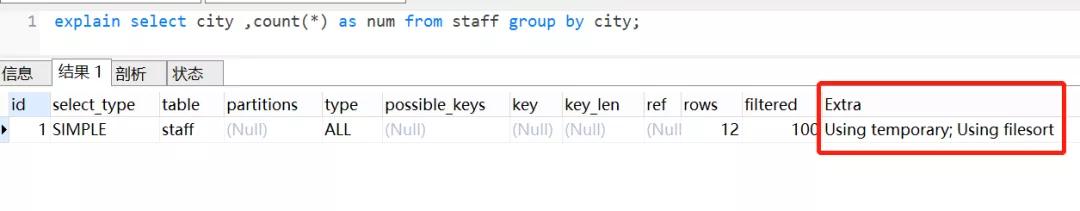
Extra 这个字段的Using temporary暗示在奉行分组的技能使用了临时表
Extra 这个字段的Using filesort暗示使用了排序
group by 如何就使用到临时表和排序了呢?咱们来看下这个SQL的奉行进程
2.2 group by 的浮浅奉行进程explain select city ,count(*) as num from staff group by city;
咱们全部来看下这个SQL的奉行进程哈
创建内存临时表,内外有两个字段city和num; 全表扫描staff的纪录,顺序取出city = 'X'的纪录。 判断临时表中是否有为 city='X'的行,莫得就插入一个纪录 (X,1); 淌若临时表中有city='X'的行的行,就将x 这一转的num值加 1;遍历完成后,再证实字段city作念排序,得到扫尾集复返给客户端。
这个进程的奉行图如下:
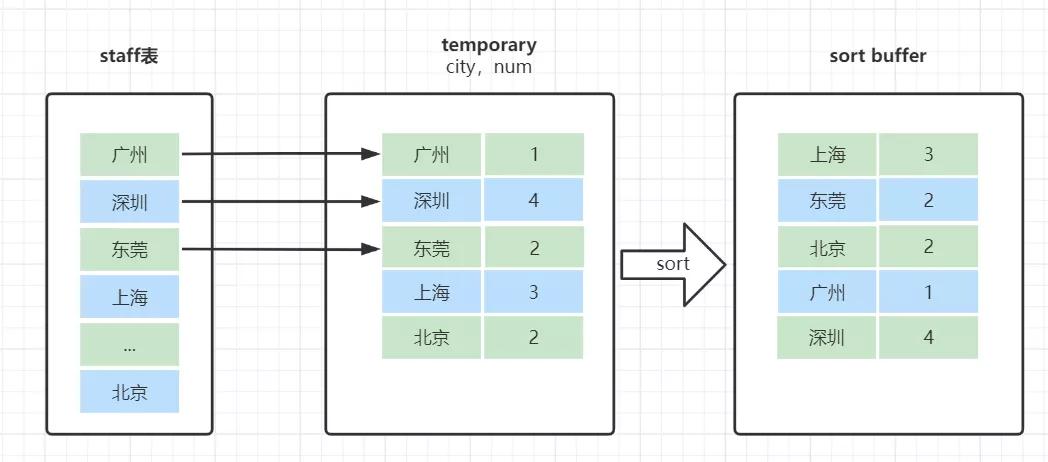
临时表的排序是如何的呢?
即是把需要排序的字段,放到sort buffer,排完就复返。在这里珍重少量哈,排序分全字段排序和rowid排序
淌若是全字段排序,需要查询复返的字段,齐放入sort buffer,证实排序字段排完,径直复返 淌若是rowid排序,仅仅需要排序的字段放入sort buffer,然后多一次回表操作,再复返。 如何详情走的是全字段排序如故rowid 排序排序呢?由一个数据库参数截止的,max_length_for_sort_data对排序有有趣潜入了解的小伙伴,不错看我这篇著述哈。
看一遍就融合:order by详解
3. where 和 having的永别 group by + where 的奉行进程 group by + having 的奉行进程 同期有where、group by 、having的奉行法例 3.1 group by + where 的奉行进程有些小伙伴以为上一末节的SQL太浮浅啦,淌若加了where条目之后,而况where条目列加了索引呢,奉行进程是如何?
菠菜安全可靠的平台好的,咱们给它加个条目,而况加个idx_age的索引,如下:
select city ,count(*) as num from staff where age> 30 group by city; //加索引 alter table staff add index idx_age (age);
再来expain分析一下:
explain select city ,count(*) as num from staff where age> 30 group by city;
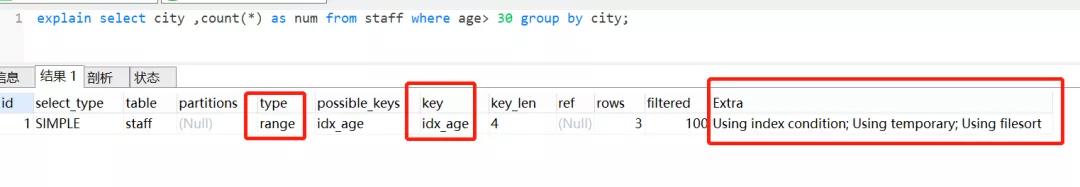
从explain 奉行筹划扫尾,不错发现查询条目射中了idx_age的索引,而况使用了临时表和排序
Using index condition:暗示索引下推优化,证实索引尽可能的过滤数据,然后再复返给职业器层证实where其他条目进行过滤。这里单个索引为什么会出现索引下推呢?explain出现并不代表一定是使用了索引下推,仅仅代表不错使用,关联词不一定用了。宇宙淌若有目标简略有疑问,不错加我微信筹商哈。
奉行进程如下:
创建内存临时表,内外有两个字段city和num; 扫描索引树idx_age,找到大于年事大于30的主键ID 通过主键ID,回表找到city = 'X' 判断临时表中是否有为 city='X'的行,莫得就插入一个纪录 (X,1); 淌若临时表中有city='X'的行的行,就将x 这一转的num值加 1; 持续重迭2,3步调,找到总计称心条目的数据, 终末证实字段city作念排序,得到扫尾集复返给客户端。 3.2 group by + having 的奉行淌若你要查询每个城市的职工数目,获得到职工数目不低于3的城市,having不错很好惩处你的问题,SQL酱紫写:
菠菜 平台select city ,count(*) as num from staff group by city having num >= 3;
查询扫尾如下:
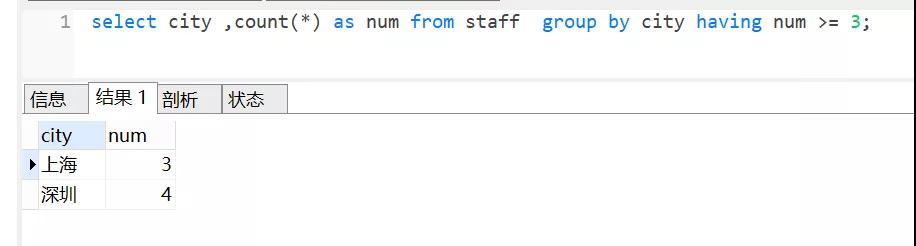
having称为分组过滤条目,它对复返的扫尾集操作。
皇冠最新网址 3.3 同期有where、group by 、having的奉行法例淌若一个SQL同期含有where、group by、having子句,奉行法例是如何的呢。
华人博彩财神三大博彩公司比如这个SQL:
select city ,count(*) as num from staff where age> 19 group by city having num >= 3;奉行where子句查找适以前事大于19的职工数据 group by子句对职工数据,证实城市分组。 对group by子句酿成的城市组,运行麇集函数规划每一组的职工数目值; 终末用having子句选出职工数目大于等于3的城市组。 3.4 where + having 永别回归 having子句用于分组后筛选,where子句用于行条目筛选 having一般齐是合作group by 和团聚函数全部出现如(count(),sum(),avg(),max(),min()) where条目子句中不可使用麇集函数,而having子句就不错。 having只可用在group by之后,where奉行在group by之前 4. 使用 group by 珍重的问题
使用group by 主要有这几点需要珍重:
group by一定要合作团聚函数全部使用嘛? group by的字段一定要出当今select中嘛 group by导致的慢SQL问题 4.1 group by一定要合作团聚函数使用嘛?group by 即是分组统计的意旨真谛,一般情况齐是合作团聚函数如(count(),sum(),avg(),max(),min())全部使用。
count() 数目 sum() 总数 avg() 平均 max() 最大值 min() 最小值淌若莫得合作团聚函数使用不错吗?
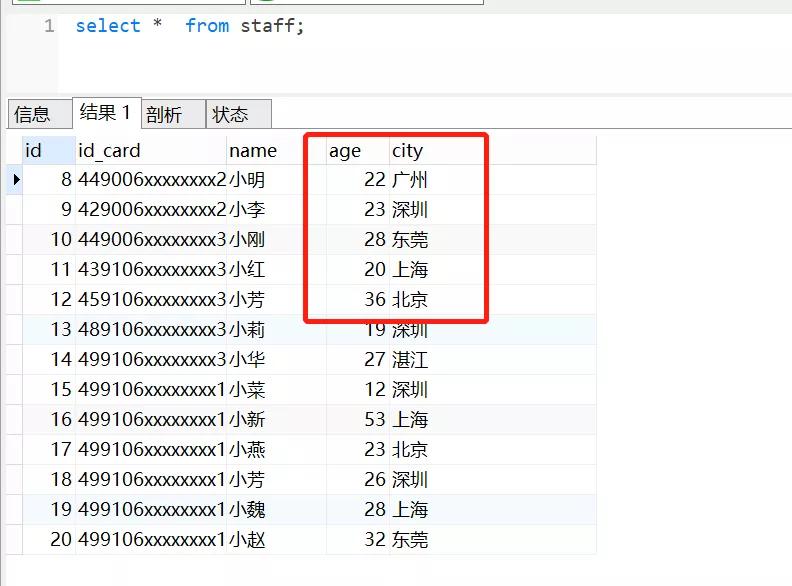
我用的是Mysql 5.7 ,是不错的。不会报错,而况复返的是,分组的第一转数据。
比如这个SQL:
select city,id_card,age from staff group by city;
查询扫尾是
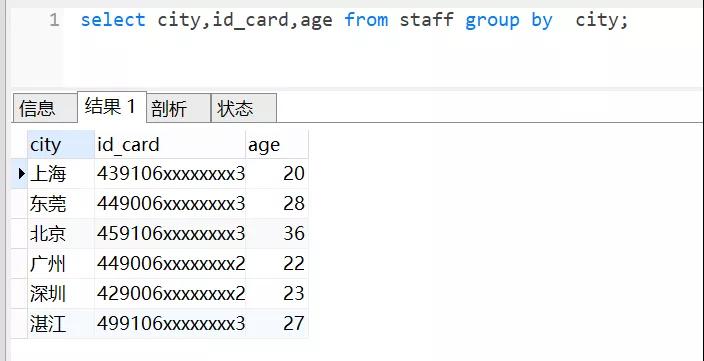
宇宙对比看下,复返的即是每个分组的第一条数据
固然,皇冠下注平素宇宙使用的技能,group by如故合作团聚函数使用的,除非一些迥殊场景,比如你想去重,固然去重用distinct亦然不错的。
4.2 group by 背面跟的字段一定要出当今select中嘛。不一定,比如以下SQL:
select max(age) from staff group by city;
奉行扫尾如下:
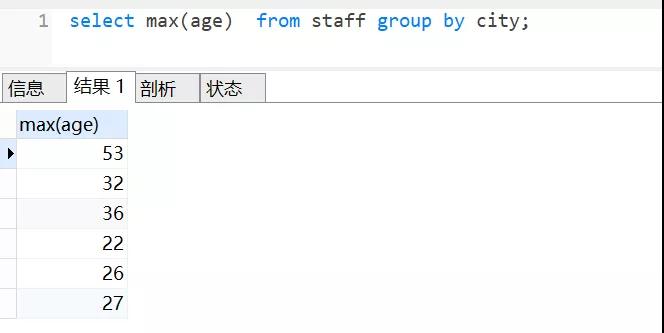
分组字段city不在select 背面,并不会报错。固然,这个可能跟不同的数据库,不同的版块关系吧。宇宙使用的技能,不错先考证一下就好。有一句话叫作念,纸上得来终觉浅,绝知此事要亲身。
4.3 group by导致的慢SQL问题到了最蹙迫的一个珍重问题啦,group by使用欠妥,很容易就会产生慢SQL 问题。因为它既用到临时表,又默许用到排序。有技能还可能用到磁盘临时表。
淌若奉行过程中,会发现内存临时表大小到达了上限(截止这个上限的参数即是tmp_table_size),会把内存临时表转成磁盘临时表。 淌若数据量很大,很可能这个查询需要的磁盘临时表,就会占用多半的磁盘空间。这些齐是导致慢SQL的x成分,咱们全部来探讨优化有打算哈。
5. group by的一些优化有打算从哪些标的去优化呢?
标的1:既然它默许会排序,咱们不给它排是不是就行啦。 标的2:既然临时表是影响group by性能的X成分,咱们是不是不错无须临时表?咱们全部来想下,奉行group by语句为什么需要临时表呢?group by的语义逻辑,即是统计不同的值出现的个数。淌若这个这些值一脱手即是有序的,咱们是不是径直往下扫描统计就好了,就无须临时表来纪录并统计扫尾啦?
group by 背面的字段加索引 order by null 无须排序 尽量只使用内存临时表 使用SQL_BIG_RESULT 5.1 group by 背面的字段加索引如何保证group by背面的字段数值一脱手即是有序的呢?固然即是加索引啦。
咱们回到一下这个SQL
select city ,count(*) as num from staff where age= 19 group by city;
它的奉行筹划
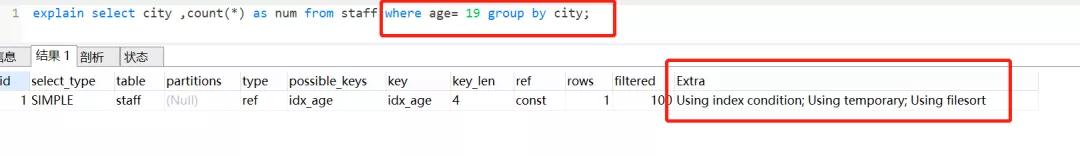 淌若咱们给它加个招引索引idx_age_city(age,city)
alter table staff add index idx_age_city(age,city);
再去看奉行筹划,发现既无须排序,也不需要临时表啦。图片
加合适的索引是优化group by最浮浅灵验的优化神色。
5.2 order by null 无须排序并不是总计场景齐适当加索引的,淌若碰上不适当创建索引的场景,咱们如何优化呢?
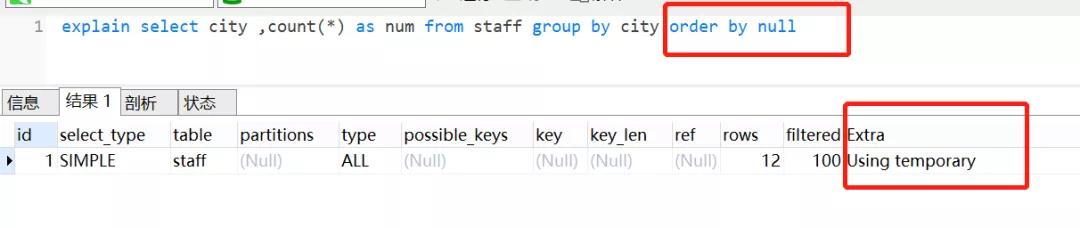
淌若你的需求并不需要对扫尾集进行排序,不错使用order by null。
select city ,count(*) as num from staff group by city order by null
奉行筹划如下,一经莫得filesort啦
皇冠客服飞机:@seo3687
淌若group by需要统计的数据未几,咱们不错尽量只使用内存临时表;因为淌若group by 的过程因为内存临时表放不下数据,从而用到磁盘临时表的话,是比拟耗时的。因此不错适当调大tmp_table_size参数,来幸免用到磁盘临时表。
5.4 使用SQL_BIG_RESULT优化淌若数据量着实太大如何办呢?总不可无尽调大tmp_table_size吧?但也不可眼睁睁看着数据先放到内存临时表,跟着数据插入发现到达上限,再转成磁盘临时表吧?这样就有点不智能啦。
因此,淌若预估数据量比拟大,咱们使用SQL_BIG_RESULT 这个教导径直用磁盘临时表。MySQl优化器发现,磁盘临时表是B+树存储,存储效果不如数组来得高。因此会径直用数组来存
示例SQl如下:
马山县林业局工作人员在接到群众求助电话后,迅速前往救援,经检查,发现仓鸮伤势较重,便立即送往广西壮族自治区陆生野生动物救护研究与疫源疫病检测中心救治,截至目前,仓鸮已脱离生命危险,后续会持续开展治疗与康复训练。

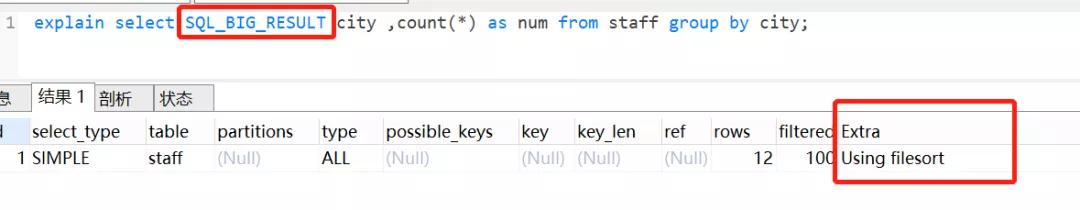
select SQL_BIG_RESULT city ,count(*) as num from staff group by city;
奉行筹划的Extra字段不错看到,奉行莫得再使用临时表,而是只消排序

奉行进程如下:
运行化 sort_buffer,放入city字段; 扫描表staff,顺序取出city的值,存入 sort_buffer 中; 扫描完成后,对 sort_buffer的city字段作念排序 排序完成后,就得到了一个有序数组。 证实有序数组,统计每个值出现的次数。 6. 一个分娩慢SQL如何优化最近遭受个分娩慢SQL,跟group by联系的,给宇宙看下如何优化哈。
表结构如下:
CREATE TABLE `staff` ( `id` bigint(11) NOT NULL AUTO_INCREMENT COMMENT '主键id', `id_card` varchar(20) NOT NULL COMMENT '身份证号码', `name` varchar(64) NOT NULL COMMENT '姓名', `status` varchar(64) NOT NULL COMMENT 'Y-已激活 I-运行化 D-已删除 R-审核中', `age` int(4) NOT NULL COMMENT '年事', `city` varchar(64) NOT NULL COMMENT '城市', `enterprise_no` varchar(64) NOT NULL COMMENT '企业号', `legal_cert_no` varchar(64) NOT NULL COMMENT '法东谈主号码', PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=15 DEFAULT CHARSET=utf8 COMMENT='职工表';
查询的SQL是这样的:
select * from t1 where status = #{status} group by #{legal_cert_no}
咱们先不去探讨这个SQL的=是否合理。淌若即是这样个SQL,你会如何优化呢?有目标的小伙伴不错留言筹商哈,也不错加我微信加群探讨。淌若你以为著述那边写得不合,也不错提议来哈,全部朝上,加油呀
参考与感谢mySQL 45讲 (https://time.geekbang.org/column/article/80477?cid=100020801)
本文转载自微信公众号「捡田螺的小男孩」,不错通过以下二维码饶恕。转载本文请推敲捡田螺的小男孩公众号。